
今晚的科技圈,被一条消息「闪」亮了。阿里通义千问正式发布并开源 Qwen3.8-Flash——不是预告、不是内测,是实打实的「今晚就上」;不是小修小补,而是架构级的跃迁;不是闭门造车,而是把下一代 Qwen4 的「心脏雏形」提前拆开、摊在开发者面前,连螺丝钉都标好了型号。这哪是发模型?这是一场面向智能基建时代的公开技术路演。
一、架构:125B 总参、仅激活 6B,效率新基准
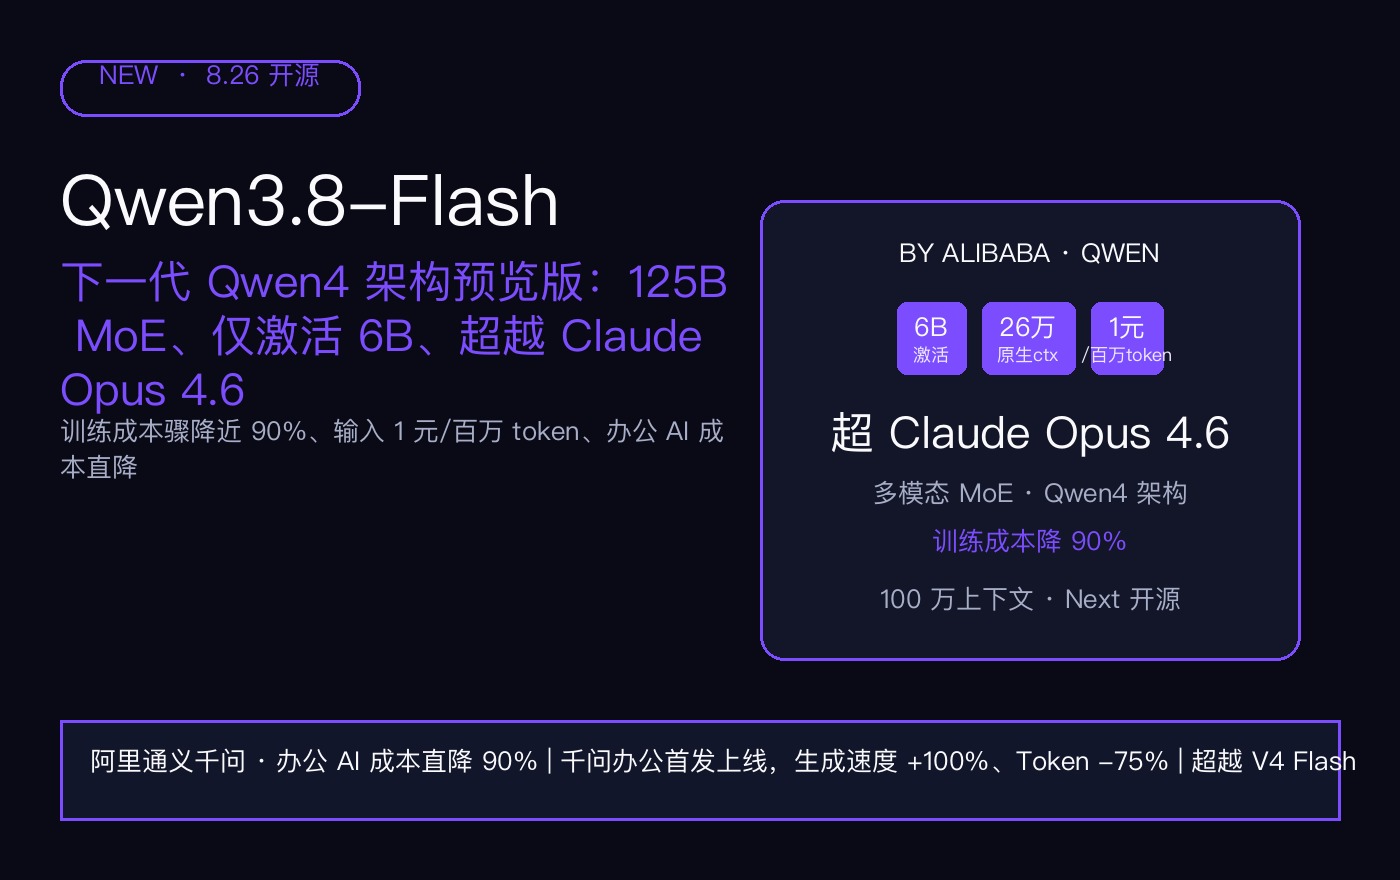
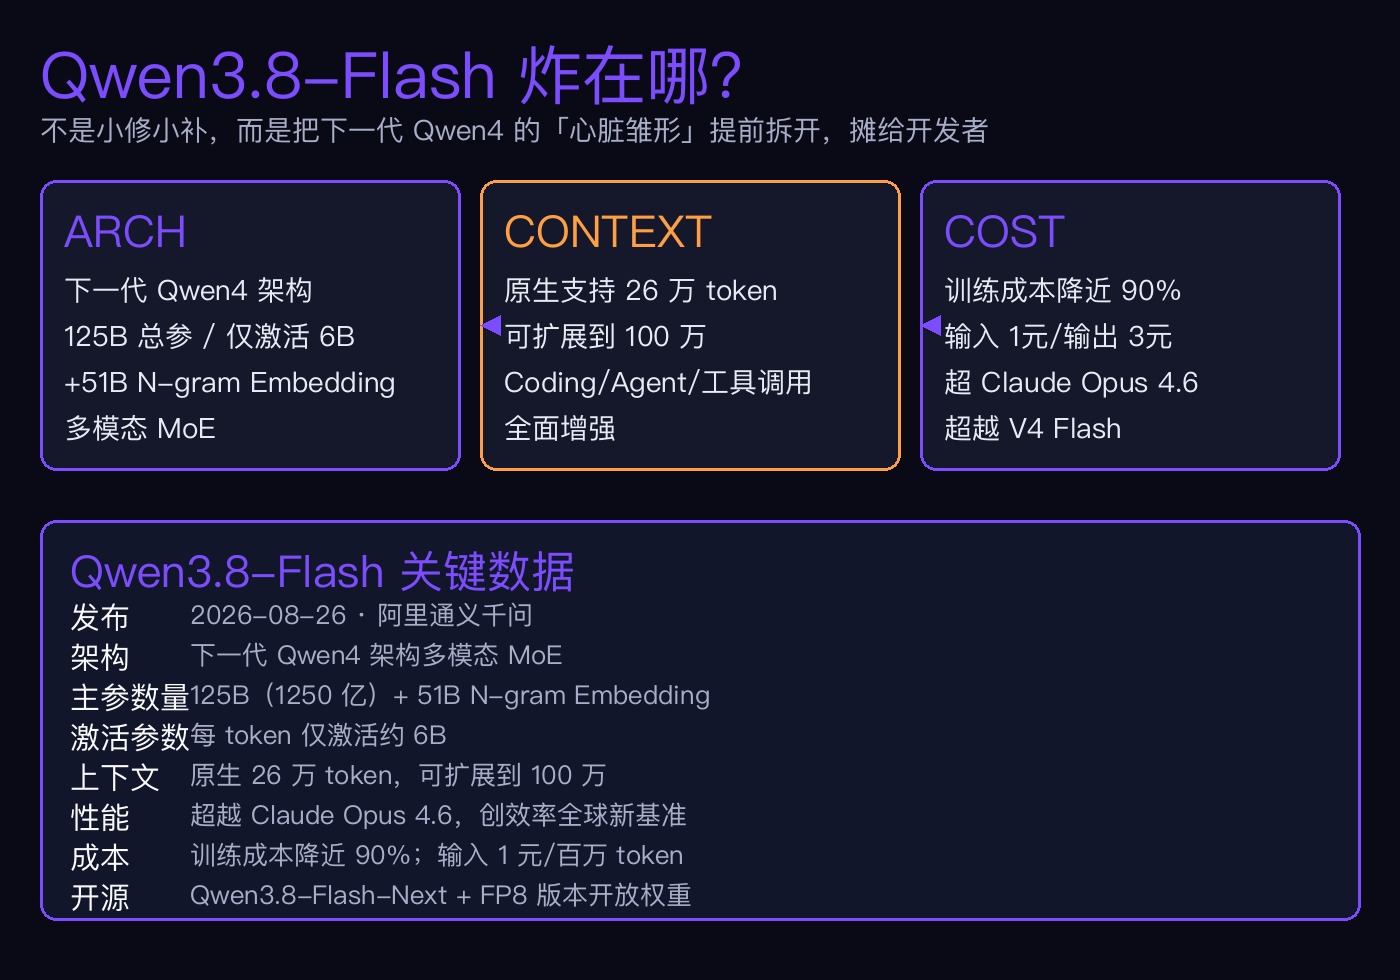
Qwen3.8-Flash 最震撼的地方在架构。它是一款多模态 MoE(混合专家)模型,主模型参数量 125B(约 1250 亿),额外配备 51B 的 N-gram Embedding 参数——但每个 token 只激活约 6B 参数。换句话说,这是一款「千亿级总参、十亿级激活」的模型,用极低的推理成本,拿到了超越 Claude Opus 4.6 的前沿性能,创下模型效率的全球新基准。
二、上下文与能力:26 万原生,可扩到 100 万
上下文方面,Qwen3.8-Flash 原生支持 262,144(约 26 万)token,可扩展到 100 万 token。Coding、Agent、工具调用等能力都在这次更新中继续增强。生产版本(Qwen Cloud 上命名为 Qwen3.8-Flash)默认就是 100 万 token 上下文——对长文档、完整代码库、长程 Agent 任务来说,这几乎是「一把梭」的容量。
三、成本:训练骤降 90%,输入 1 元/百万 token
比性能更「炸」的,是成本。得益于架构与训练的全面革新,Qwen3.8-Flash 的训练成本较上一代 Qwen3.7-Plus 骤降近 90%,推理成本也大幅下降:每百万 token 输入仅 1 元、输出 3 元。有媒体形容,这一手直接重划了大模型的「性价比斩杀线」——当各家纷纷上调 API 价格或收紧免费额度时,阿里把价格打到了对手的零头,也让办公 AI 的成本直降 90%。
四、开源:Qwen3.8-Flash-Next = Qwen4 雏形
阿里同步开源了 Qwen3.8-Flash-Next 及 FP8 版本的开放权重。诚如官方所说,这个早期版本是给开发者社区一个提前上手、为完整 Qwen4 模型家族做准备的机会。它基于下一代 Qwen4 架构,名字虽还挂着 3.8,实际上是新架构的「技术预览版」——想提前知道 Qwen4 长什么样,就从 Qwen3.8-Flash-Next 开始。
五、落地:千问办公首发上线,速度 +100%、Token -75%
模型发布第二天(8 月 27 日),阿里旗下千问办公就首发上线了 Qwen3.8-Flash,并同步推出「标准模式」。官方称,标准模式下 Token 消耗平均减少 75%,生成速度提升 100%。你用的钉钉文档自动润色、飞书会议实时摘要这类办公 AI,很可能已经在背后悄悄换上了这个新模型——用更低的成本,提供更快的响应。
结语
Qwen3.8-Flash 的发布,本质上是阿里的一次「技术秀肌肉」:把下一代架构的性能和成本,一起摊开放给全世界看。千亿总参、6B 激活、超越 Opus 4.6、训练降 90%、输入 1 元——当这些数字同时成立,它重划的就不只是价格,而是「高效模型到底能做到多好」的预期。而真正的正餐,大概要等完整的 Qwen4 系列登场。
如果这篇文章对你有帮助,欢迎分享给正在选择 AI 工具的朋友。