
AI 视频早就能生成让人眼前一亮的片段了,真正难的,是让那些片段「听你指挥」——按你想要的动作动、保住重要的画面元素、改一下而不用整段重来。谷歌 8 月 27 日发布的 Gemini Omni 1.1 Flash,就是冲着「可控」这两个字来的:把视频的长度、衔接、分辨率选择权,更多地交回创作者手里。
一、核心升级:40 秒场景扩展,不再只参考最后 1 秒
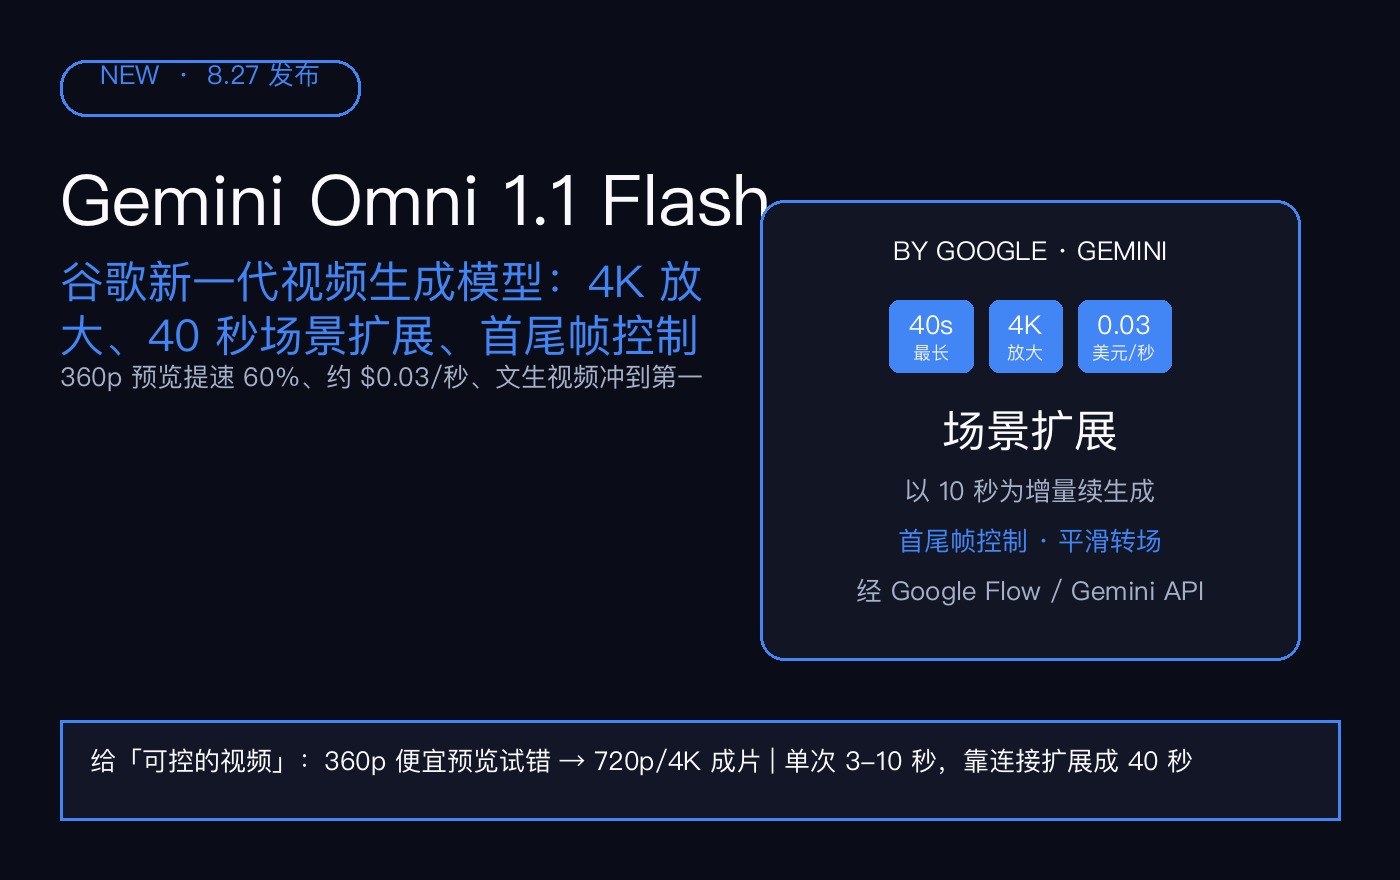
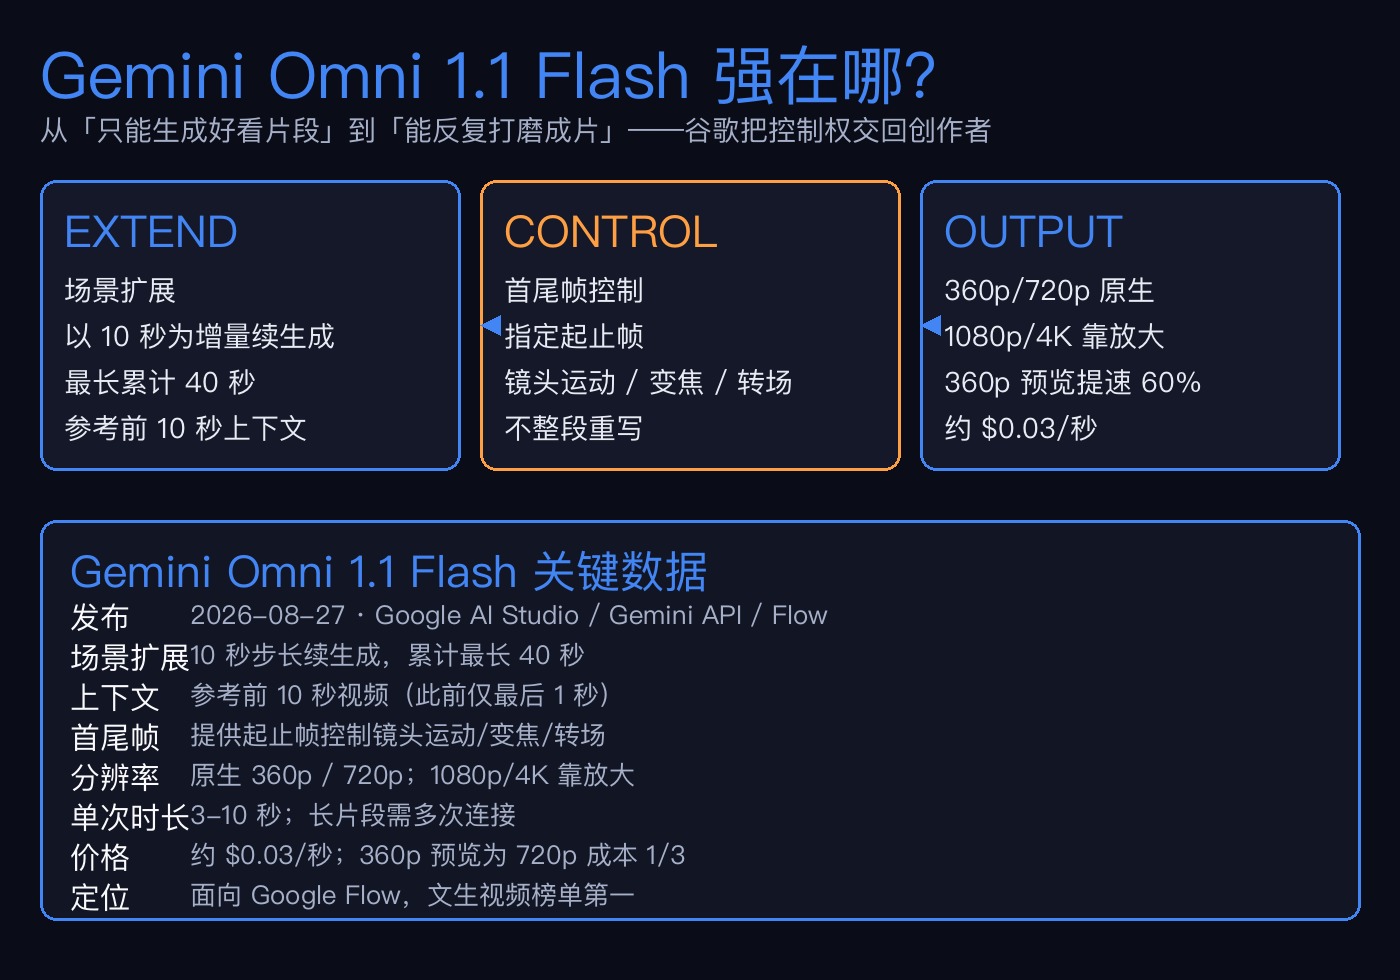
Gemini Omni 1.1 Flash 最突出的能力是「场景扩展」。新模型可以分析此前最多 10 秒的视频内容,以 10 秒为增量继续生成,单条累计最长能延到 40 秒。这比上一代模型进步明显——此前它只参考最后 1 秒。多出来的这些「前情提要」,让模型有更多信息判断场景里正在发生什么,从而在视频延续时保持角色、场景和动作的一致。
不过要注意它的边界:单次只能生成 3-10 秒视频,40 秒的最大值要靠反复的 10 秒扩展一点点「接」出来;谷歌也把视频参考输入限制在 3 秒以内,所以它并不擅长拿一整段长素材从开头到结尾做自由改造。
二、首尾帧控制:指定起止帧,做出镜头运动与转场
另一个新卖点是首尾帧生成。开发者可以提供序列的起始帧和结束帧,让模型生成这两帧之间的运动——这正是做运镜、变焦、转场的基础,而不需要让模型凭空脑补整段镜头。对想保留一段已经满意的开头、只需在后半段做特定动作的团队来说,这是把「一次性出片」变成「可反复打磨」的关键一步。
三、分辨率与价格:360p 便宜试错,4K 靠放大
分辨率上,Gemini Omni 1.1 Flash 原生输出 360p 和 720p,1080p 和 4K 则通过放大(upscaling)实现,而不是原生生成。价格上,API 按 token 计费大约是 0.03 美元/秒;其中 360p 预览模式成本只有标准 720p 的三分之一,且生成提速 60%——这意味着团队可以先在低分辨率下反复试提示词、运镜、转场,等效果满意再切换到高质量输出,大幅压低反复迭代的成本。
四、生态:Google Flow 的底层,面相创作者的全流程
Gemini Omni 是一条结合文本、图像、音频、视频来创作和编辑素材的模型线,而 Google Flow 正是它的「主场」。Flow 最早是以 Veo 为核心的电影制作工作台,后来被谷歌扩展成覆盖图像生成、编辑的 AI 创意工作室。这次 Omni 1.1 Flash 的能力也在 Google Flow 中开放。开发者可通过 Google AI Studio 和 Gemini API 访问,企业客户经由 Gemini Enterprise Agent Platform 使用。有报道称,其文生视频已冲到相关榜单第一。
五、为什么值得关注:视频生成从「demo」走向「工具」
AI 视频行业的口径一直在变:从「能不能生成」到「能不能控制」。Gemini Omni 1.1 Flash 的意义,不是它能一次生成一条多长的视频(40 秒仍要靠扩展),而是它给了创作者「保留有效部分、控制下一步走向」的能力。对营销团队来说,可能已经有一条满意的开场镜头,只需延长并保持角色细节一致;对社媒创作者来说,可能只想在两段之间做一个特定运镜;对做分镜的人,可以先批量生成低分辨率版本再挑选。这些从「演示」到「生产工具」的跨越,才是这次更新真正的价值。
结语
谷歌并不指望 Gemini 用一条提示词生成整支广告或产品片。它更务实地把 AI 视频从「惊艳的一次性演示」,推向「能天天塞进生产流程的工具」。当生成过程变得更可预测、更可控制,视频 AI 离「真正可用」就近了一大步。
如果这篇文章对你有帮助,欢迎分享给正在选择 AI 工具的朋友。