
如果说 DeepSeek 此前一直是个“只会读字”的学霸,那从 8 月 21 日起,它终于长出了“眼睛”。这一天,DeepSeek 在 API 平台低调上架了一款实验性多模态模型——deepseek-v4-flash-vision-exp,这是它第一款真正支持图像输入、能“看图”的模型。
一、DeepSeek 终于“看见”了:首款图像输入多模态模型来了
和很多大厂一样,DeepSeek 一直以“文字推理”见长,但在多模态(尤其是图片理解)上没有太多动作。这次上架的 deepseek-v4-flash-vision-exp,一次性补上了这块短板:它在 V4-Flash 的架构上叠加了图像理解能力,可以描述图片内容、识别截图里的文字、分析图表数据。
注意后缀上的 “Exp”——代表这是“实验性(Experiment)”模型。它目前只通过 API 提供,尚未进入网页端或 App 的完整产品线,主要面向开发者先行体验和测试。
二、它是什么?V4-Flash 的“眼睛”,定位超性价比
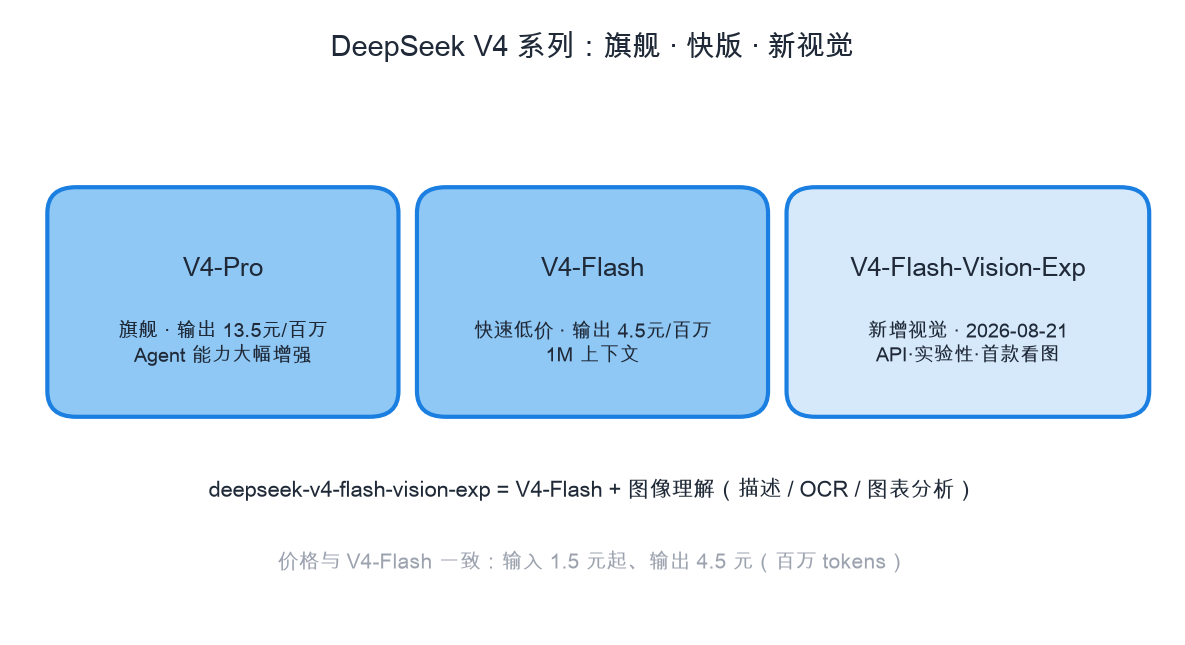
一句话概括:deepseek-v4-flash-vision-exp = V4-Flash + 图像理解。它不是一款全新的大模型,而是把“看图”能力加到原本就主打“快速低价”的 V4-Flash 上。这也决定了它的定位——不拼算力堆料,而是用尽可能低的成本,把多模态能力普惠到更多应用里。
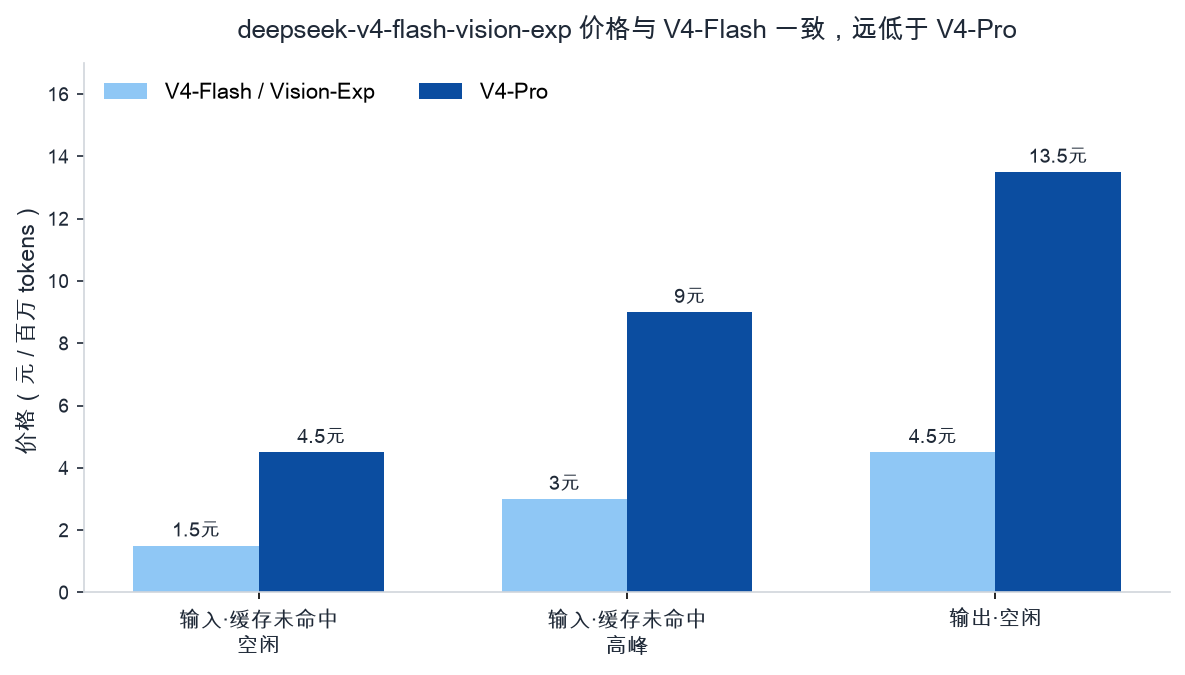
从官方 API 定价表看,它继承的正是 V4-Flash 的价格体系。输入 Token(缓存未命中)空闲时段 1.5 元/百万、高峰 3.0 元;输出 4.5 元/百万(空闲)。作为对比,旗舰 V4-Pro 同口径的价格是 4.5 / 9.0 / 13.5 元,要贵上整整 3 倍。也就是说,用第三方旗舰模型三分之一的价格,就能获得同款“看图”能力。
三、能做什么:描述图片、截图 OCR、图表分析
官方文档把它支持的场景归纳得很直接:让模型描述图片、识别截图中的文字、分析图表等。往深里说,这就等于给一大批“重度依赖截图”的场景开了闸——发票/票据 OCR、截图聊天记录提取、报表数据读取、界面截图答疑、电商商品图文案生成等等,都能在这款廉价模型上自动化。
支持的图片格式为 JPEG、PNG、GIF、WebP,并且官方强调格式以文件“实际内容”判断,而不是看文件名或声明的 MIME 类型——细节做得很扎实。
四、怎么喂图?三种传图方式 + detail 细节级别
deepseek-v4-flash-vision-exp 兼容 OpenAI 的 Chat Completions 格式,图片以 content 块数组传入。官方提供了三种传图方式,开发者可按需选:
Base64 内联 data URL:把图片编码后直接嵌进请求,适合本地文件,受 48 MiB 请求体大小限制。
外部图片 URL:传入一个可公开访问的 http(s) 链接,模型自动下载;URL 最长 8192 字符、图片最大 32 MiB、需 60 秒内下载完成。
Files API 的 file_id:先上传一次图片,之后用返回的 file_id 引用;最大可达 64 MiB,且不设 32 MiB 单图检查,适合大图或多次复用。
对于 image_url 输入,还可以选填 detail 字段控制分辨率:low 会把图片缩到 512×512,追求更快更省 token;high 与原图等价(为兼容提供);original 保留原图;auto 自动选择(当前等价于 original)。这和主流多模态模型的“详情级别”思路一致,方便做成本调优。
五、规格亮点:1M 上下文、384K 输出、Tool Calls 与 Responses API
别看它便宜,规格并不寒酸:上下文长度 1M,最大输出 384K token,并发限制 2500。接口层面走的是 OpenAI 兼容格式,BASE URL 为 api.deepseek.com,同时提供 Anthropic 格式的 api.deepseek.com/anthropic 入口。
在功能上,它支持 JSON Output、Tool Calls(工具调用)、Responses API、对话前缀续写(Beta)等,通过 Anthropic API 也能接入;唯一的“遗憾”是不支持 FIM 补全(仅限文本续写场景)。对开发 Agent 或做自动化流程的人来说,Tool Calls + Responses API + 视觉的三件套,正是当下最要紧的组合。
六、行业怎么看:与 Claude Opus 4.8、Gemini 3.7 同题竞争
模型上线后,很快被媒体和评测社区拿来与海外头部模型对比。有日媒以“Opus 4.8 匹敌”为标题报道其多模态能力,也有评测将其放到 Gemini 3.7 旁边做横向比较,讨论它在一个要求“多模态 Agent”的核心基准上的表现。换句话说,大家关心的不只是“能不能看图”,而是“看图 + 干活”(Agent)成不成熟。
虽然它顶着“Exp 实验”的之名,能力尚在打磨,但以 V4-Flash 的价格把视觉多模态的门槛打进“个位数/百万 token”,无疑给国内开发者提供了一条性价比极高的落地路径。
结语:国产模型的“多模态平价”时刻
deepseek-v4-flash-vision-exp 的意义,不只是 DeepSeek 补上了一张“视觉”拼图,更像是在宣告一个趋势:多模态正在快速“平价化”。当“看图”的成本被压到 1.5 元/百万 token 起步,OCR、截图理解、图表分析这类曾经要依仗昂贵旗舰模型、甚至第三方服务的需求,从此有了更亲民的选择。对开发者来说,这无疑是值得第一时间接入尝鲜的一波行情。
官网入口:api-docs.deepseek.com/zh-cn/guides/vision/ | 定价:api-docs.deepseek.com/zh-cn/quick_start/pricing/。由于是实验性模型,建议上线前先在测试环境验证识别效果与限速表现。
如果这篇文章对你有帮助,欢迎分享给正在选择 AI 工具的朋友。