
在 DeepSeek、阿里、Moonshot 把开源大模型卷到新高度的 2026 年夏天,腾讯憋了大半年,终于交出了一份沉甸甸的「暑假作业」。8 月 28 日,腾讯发布并开源最新一代旗舰模型——混元 Hy4 preview(770B-A49B)。这次不是小步快跑,而是直接把参数规模、上下文和 Agent 能力一起拉满,并放话在内部测试中超过了 Z.ai 与 Moonshot。
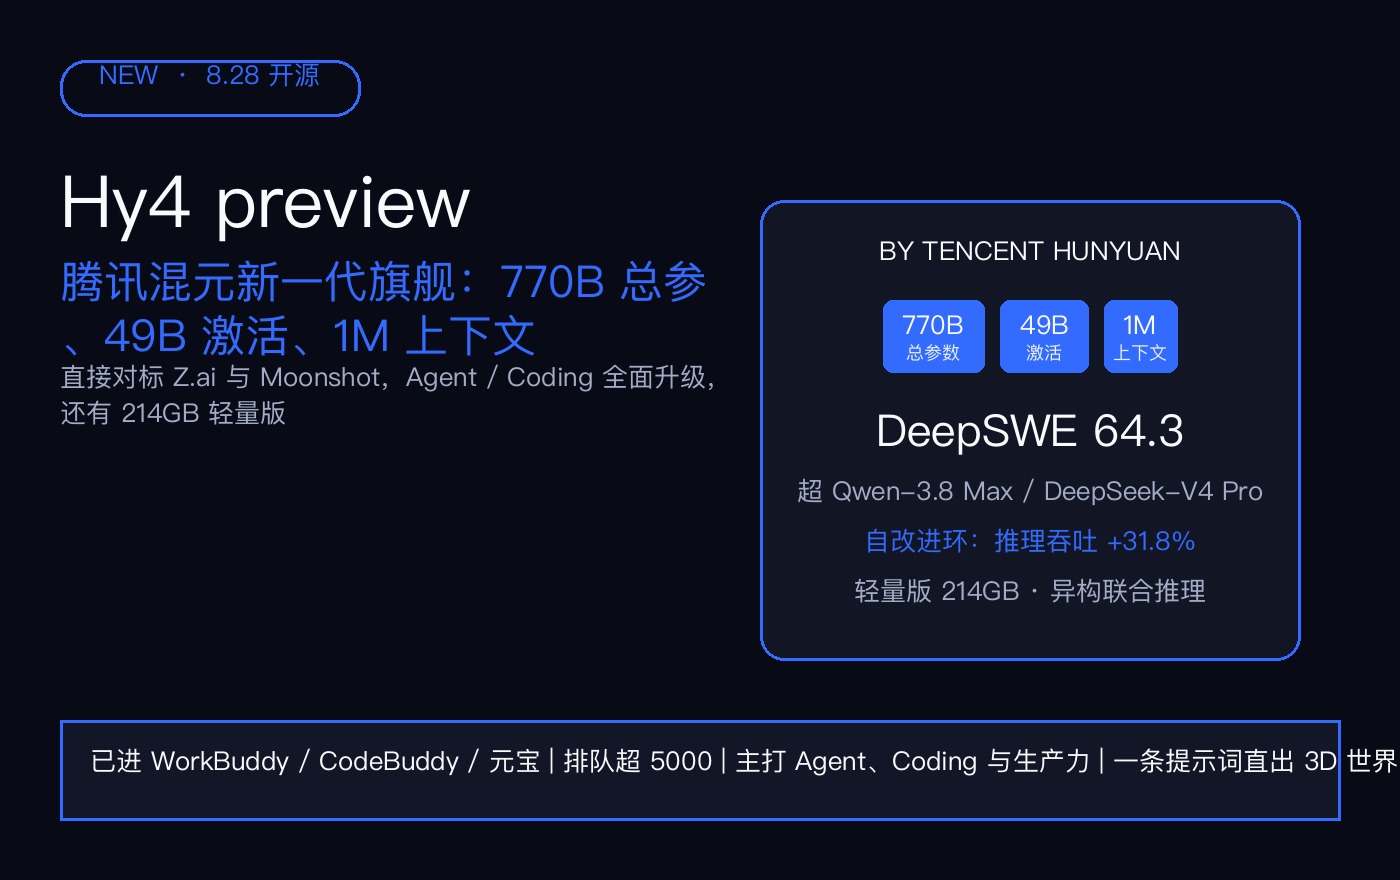
一、规格拉满:770B 总参、49B 激活、1M 上下文
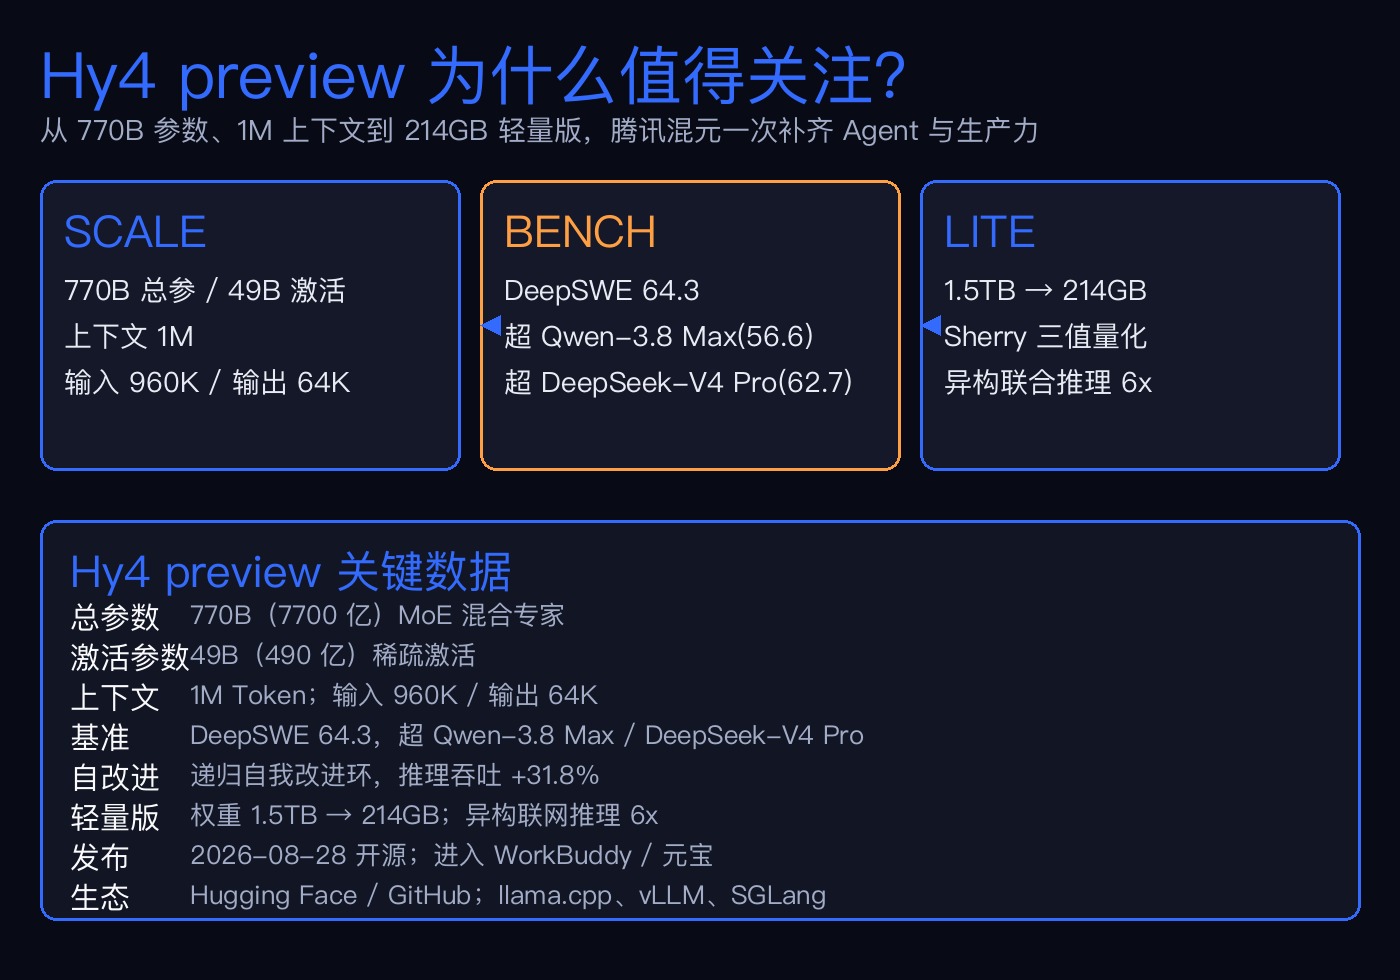
Hy4 preview 是腾讯混元(Tencent Hunyuan)新一代 MoE(混合专家)大模型,总参数量 770B(7700 亿),激活参数 49B(490 亿),上下文长度达到 1M(100 万 Token),最大输入 960K、最大输出 64K。相比上一代 Hy3 的 295B 总参、21B 激活、256K 上下文,这几乎是翻着倍地跃升——尤其是上下文从 256K 跳到 1M,意味着它能一口气吃下整本长文档或完整代码库来干活。
二、基准:DeepSWE 64.3,超过两家对手
腾讯称 Hy4 preview 在内部测试中表现优于 Z.ai 与 Moonshot。第三方基准也给出佐证:在 DeepSWE 编程基准上,Hy4 preview 得 64.3,超过阿里 Qwen-3.8 Max 的 56.6 和 DeepSeek-V4 Pro 的 62.7。腾讯混元官方把它定位为「新一代生产力模型」,重点面向 Agent、Coding 与生产力场景优化,强化复杂任务中的理解、规划、工具调用与持续执行能力。
三、自改进环:推理吞吐提升 31.8%
Hy4 preview 还有一个值得开发者注意的细节——递归自我改进环。腾讯披露,Hy4 使用一个循环式自我提升机制,以自己的输出反哺后续推理,从而把自身推理吞吐提升了 31.8%。官方也提醒开发者,在使用这类带自改进能力的模型时,要注意其在持续迭代中可能产生的行为变化。
四、轻量版:1.5TB 压到 214GB,异构设备联合推理
配得上「旗舰开源」的,还要让普通开发者跑得动。9 月 1 日,腾讯混元推出 Hy4 preview 轻量版,将模型权重从接近 1.5TB 压缩至约 214GB。压缩依托两项核心技术:一是 Sherry 稀疏三值量化算法,把路由专家层权重压到平均 1.25 比特;二是 MIX-STQ1_0 混合精度策略,依据校准数据逐层决定量化位宽,敏感层保留较高精度、不敏感层用更激进的 1.31 比特。
关键是在压缩之后性能没有明显塌方:长文理解几乎与原始 BF16 模型持平,多轮长上下文检索基本同一水平,数学能力仅小幅回落(MCP Atlas 从 83.7 微降至 83.2,SWE-Bench multi 从 82.9 降至 81.3)。腾讯混元还与 prima.cpp 合作,在一张 4090 笔记本 + 四卡 A4000 服务器(合计 80GB 显存、64GB 内存、分属两个局域网)上通过异构调度拆分 MoE 层,让 214GB 轻量版达到 1.02 token/s 的推理速度,比笔记本单机 offload 快约 6 倍。
五、生态:已进 WorkBuddy、元宝,上线即爆火
Hy4 preview 已经同步进入腾讯系的多个产品:WorkBuddy、CodeBuddy、元宝等。上线之初排队人数就超过 5000,据媒体实测,它能用一条提示词直出 3D 开放世界游戏;而轻量版也已上线 Hugging Face 和 GitHub,支持 llama.cpp、vLLM、SGLang 等主流推理框架。腾讯混元覆盖文本、图像、视频、语音、3D 等多种模态,客户包括腾讯游戏、腾讯视频、QQ、企业微信、微信支付等。
结语
Hy4 preview 的意义在于,腾讯把「旗舰实力」和「人人都能用」这两件事一起做了:一面是 770B 参数、1M 上下文、DeepSWE 64.3 的硬实力,另一面是 214GB 轻量版 + 异构联合推理,让个人开发者也能跑起来。当开源大模型的竞争从「谁更强」卷到「谁更易用」,腾讯混元这一手,算是把 Agent 与生产力赛道的牌补齐了。
如果这篇文章对你有帮助,欢迎分享给正在选择 AI 工具的朋友。