
一、Hugging Face 是什么?
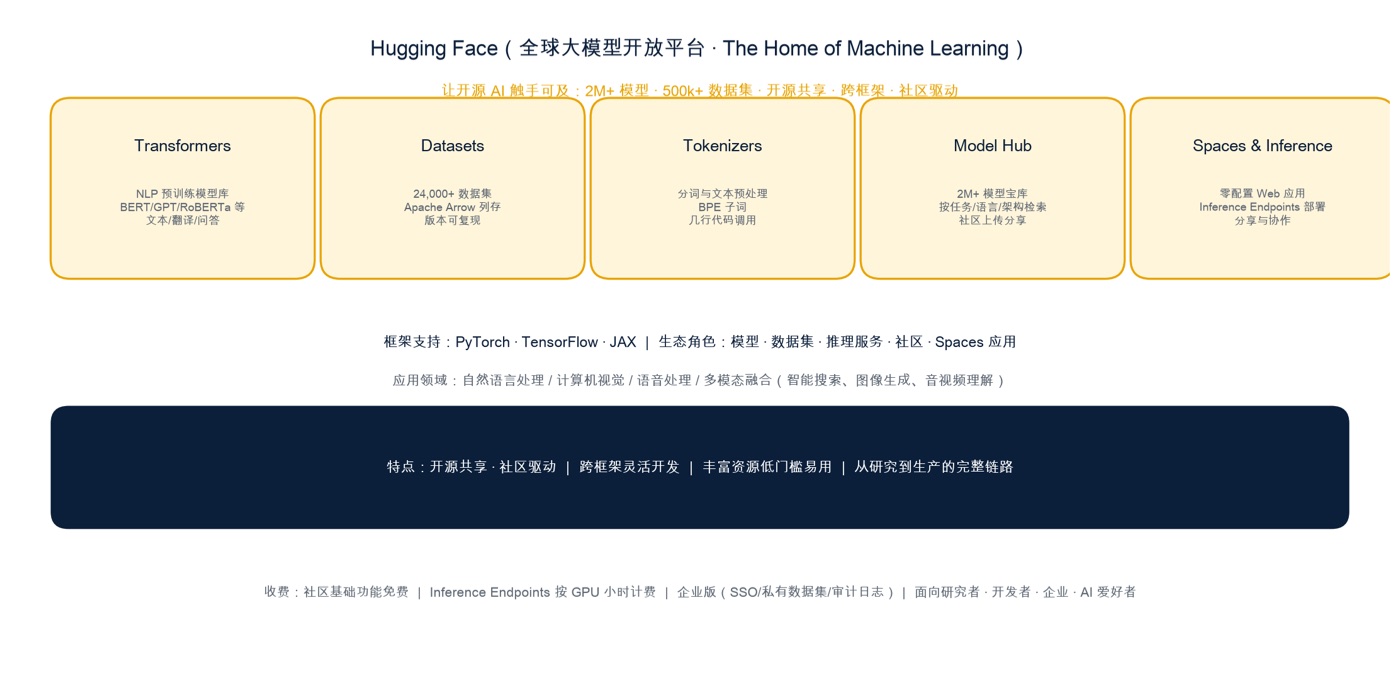
Hugging Face 成立于 2016 年,作为全球大模型开放平台,其愿景是「让人工智能技术惠及大众」。它最初以开发聊天机器人起步,后来转型为专注开源 AI,尤其是自然语言处理(NLP),发展至今已形成包含模型、工具、数据集与社区的庞大生态:
模型(Models):汇聚全球超过 200 万个模型,涵盖学术与工业界前沿成果以及全球开发者上传分享的自有模型。
数据集(Datasets):提供超过 50 万个数据集,覆盖 NLP、计算机视觉、语音、强化学习等多个领域。
工具与库:Transformers、Datasets、Tokenizers 等主流开源库。
社区(Community):全球 AI 开发者与研究者高度活跃的核心聚集地。
二、核心产品与功能
1. Transformers 库
Hugging Face 最璀璨的明珠,实现并维护着海量预训练语言模型,如 BERT、GPT、RoBERTa 等。支持文本分类、情感分析、机器翻译、文本生成、问答系统等丰富 NLP 任务,并兼容 PyTorch、TensorFlow 与 JAX,极大降低开发门槛。
2. Datasets 库
专为机器学习任务打造的数据集处理利器:内置数万个各类数据集,覆盖 NLP、视觉、音频、强化学习等领域(如 SQuAD、IMDB 等),底层采用 Apache Arrow 列式内存格式,支持数据版本控制以保障实验可复现,并与 Transformers 及 PyTorch 无缝集成。
3. Tokenizers 库
专注文本分词与预处理:提供众多预训练分词算法(如 Byte Pair Encoding / BPE 子词分词),支持训练自定义分词器以满足医疗、金融等专业领域需求,几行代码即可调用预训练分词器高效完成文本预处理。
4. Model Hub(模型宝库)
堪称模型的「宝藏仓库」,汇聚 200 万+ 模型。可依据任务类型、模型架构、语言等多维度精准搜索、浏览与免费下载,加速 AI 项目开发;同时支持社区上传分享。
5. 推理 API 与 Hugging Face Spaces
推理 API(Inference Endpoints):几行代码即可部署模型推理,从概念验证到小项目、再到大规模生产都能提供稳定服务。
Spaces:友好的零配置环境,轻松构建 Web 应用、托管演示并与社区协作,哪怕不熟悉 Web 开发也能快速搭建可视化 AI 应用。
三、平台特点
开源共享,社区驱动:模型、代码、工具与数据大多免费开放,社区踊跃分享经验、举办竞赛,激励创新。
跨框架支持,灵活开发:Transformers 等对 PyTorch、TensorFlow、JAX 提供良好支持,开发者可在熟悉环境中灵活训练、部署。
丰富资源,低门槛易用:从海量预训练模型到多样化数据集,再到详细文档教程;初学者可快速上手,资深开发者可深度定制。
四、应用场景
自然语言处理(NLP):文本分类(新闻/邮件/舆情)、机器翻译、问答系统等。
计算机视觉(CV):图像分类、目标检测(自动驾驶障碍物识别、工业质检),以及基于文本生成图像。
语音处理:语音识别(转写)、语音合成(有声书、导航播报)。
多模态融合:基于图文描述的智能搜索、视频内容理解与生成等。
五、收费模式
免费层级:社区账号可自由访问开源模型与数据集,能用 Gradio 等工具搭建简单 demo,零门槛入门。
计算资源收费(Inference Endpoints):提供 GPU 实例,起步价约 0.60 美元/小时,按实际使用时长灵活付费,适合小项目测试与部署。
企业版方案:约 20 美元/用户/月起步,含单点登录(SSO)、私有数据集管控、审计日志,可升级获得区域支持与优先客服。
定制化企业附加服务:面向需要 SOC 2 合规等高级安全标准的大型企业,可按需定制。(以上价格以官方实时报价为准。)
六、怎么开始使用 Hugging Face?
注册账号:访问 huggingface.co 注册,获得访问模型/数据集与上传资源的能力。
安装库:用
pip install transformers datasets tokenizers安装核心开源库(Python)。加载模型:几行代码即可加载预训练模型做推理/微调。
使用官网:直接在官网搜索、下载模型/数据集,或用 Inference Endpoints 在线调用推理 API。
上手 CLI:可用现代
hf命令行(hf download/hf upload/hf datasets/hf spaces等)管理模型、数据集与 Spaces;也可搭建 Spaces 分享演示应用。合规提示:使用模型、数据集与商用部署时,请遵守对应模型的许可证与 Hugging Face 用户协议。
七、Hugging Face 常见问题(FAQ)
Q1:Hugging Face 是什么?
成立于 2016 年的全球大模型开放平台,官方口号「The AI community building the future」、定位「The Home of Machine Learning」,以开源 AI 为主,汇聚模型、工具、数据集与活跃社区。
Q2:Hugging Face 有多少模型和数据集?
官方显示已汇聚 200 万+(2M+)模型 与 50 万+(500k+)数据集(社区持续上传共享)。
Q3:Hugging Face 是开源的吗?
核心库(Transformers、Datasets、Tokenizers 等)与平台上的模型/数据集大多开源免费,社区共享;付费点主要在推理计算与企业服务。
Q4:Hugging Face 支持哪些框架?
PyTorch、TensorFlow、JAX 等主流框架,开发者可自由选择熟悉的环境。
Q5:Hugging Face 免费吗?
社区基础功能免费(访问开源模型/数据集、搭 demo);Inference Endpoints 按 GPU 小时计费(约 0.60 美元/小时起);企业版约 20 美元/用户/月起。
Q6:Hugging Face 能做什么?
文本分类、翻译、问答、图像/语音识别与生成、多模态任务等,从研究到生产的完整链路,可在线跑推理、搭 Spaces 应用。
Q7:Hugging Face 和普通 AI 聊天工具有什么不同?
它不是聊手机器人,而是开源模型与工具的大本营:供研究者/开发者检索、下载、微调、部署模型,并能用 Spaces 快速做出可视化 AI 应用。
Q8:不会编程能用 Hugging Face 吗?
可以用。直接在官网模型/数据集页免费查看、搜索、下载与在线试用(部分支持网页 demo / Spaces);但深度微调与部署需要一定 Python 基础。
八、结语:Hugging Face 的定位与价值
Hugging Face 的价值,在于它是开源 AI 的「大本营」与「基础设施」:以 Transformers、Datasets、Tokenizers 等开源库把先进的 NLP/多模态技术工程化、易用化;以 Model Hub 汇聚 200 万+ 模型、50 万+ 数据集,让「找到可用模型」变得像搜索一样简单;以 Inference Endpoints 与 Spaces 打通「研究→生产→分享」的完整链路;再以开源共享、社区驱动的文化不断注入活力。对研究者它是前沿模型与复现来源,对开发者它是高效开发底座,对企业它是可私有化、可审计的 AI 基础设施,对爱好者它是零门槛的 AI 入口。它深刻塑造着当今 AI 技术格局——正如其口号所言,「The AI community building the future」。